
به گزارش مدیاتی:گسترش سریع عاملهای هوش مصنوعی (AI Agents) در سازمانها و سرویسهای دیجیتال، فرصتهای تازهای برای خودکارسازی ایجاد کرده، اما همزمان نگرانیهای امنیتی را نیز افزایش داده است. بر اساس گزارشهای منتشرشده، استفاده گسترده از این عاملها میتواند به شکلگیری دهها هزار حادثه امنیتی منجر شود؛ زیرا AI Agents برخلاف ابزارهای سنتی، قادرند به سامانهها و دادهها دسترسی داشته باشند و بهصورت خودکار اقدام کنند. همین ویژگی، شناسایی، نظارت و کنترل رفتار آنها را به یکی از چالشهای مهم امنیت سایبری تبدیل کرده است.
دهها هزار حادثه امنیتی با عاملهای هوش مصنوعی؛ کنترل AI Agents سختتر از همیشه میشود
گزارش تازهای از ابعاد گسترده رفتارهای غیرمنتظره و گاه خطرناک عاملهای هوش مصنوعی پرده برداشته است. طبق گزارش Axios، شرکتهای OpenAI و Anthropic به همراه پژوهشگران امنیتی در حال بررسی دهها هزار حادثه امنیتی هستند که در جریان آزمایش مدلهای پیشرفته و همچنین در برخی موارد در دنیای واقعی رخ دادهاند. این حوادث از دور زدن محدودیتهای امنیتی و تلاش برای خروج از محیطهای آزمایشی گرفته تا دسترسی غیرمجاز به سامانهها و وبسایتها را شامل میشود.
این تحولات در حالی رخ میدهد که طی ماههای اخیر چندین نمونه جدی از رفتار غیرمنتظره عاملهای هوش مصنوعی آشکار شده است؛ از جمله حادثهای که در آن عاملهای مورد آزمایش OpenAI از محیط ایزوله خود خارج شدند و به زیرساختهای Hugging Face دسترسی پیدا کردند. OpenAI در گزارش فنی خود تأیید کرده است که مدلهای مورد آزمایش با دور زدن برخی کنترلها به اینترنت متصل شدند، از آسیبپذیریهای زیرساختی استفاده کردند و به سامانههای شخص ثالث دسترسی یافتند.
دهها هزار حادثه؛ اما همه آنها به معنی هک موفق نیستند
رقم «دهها هزار» در نگاه اول بسیار نگرانکننده به نظر میرسد، اما باید توجه داشت که همه این موارد به حمله سایبری موفق یا آسیب واقعی منجر نشدهاند. بخشی از این اتفاقات در جریان آزمایشهای امنیتی و Red Teaming رخ دادهاند؛ آزمایشهایی که هدف آنها وادار کردن مدل به عبور از محدودیتها برای شناسایی نقاط ضعف سیستم است.
با این حال، تعداد بالای این رخدادها نشان میدهد حتی درصد کوچکی از رفتارهای غیرهمسو، زمانی که صدها هزار یا میلیونها اجرای آزمایشی انجام میشود، میتواند به تعداد قابلتوجهی حادثه منجر شود. Axios گزارش داده است که این موارد شامل تلاش برای دور زدن گاردریلها، ایجاد کانالهای ارتباطی غیرمجاز، خروج از محیطهای سندباکس، ربایش یا دستکاری وبسایتها و تلاش برای دور زدن سامانههای نظارتی بوده است.
ماجرای Hugging Face؛ نقطه عطفی در امنیت عاملهای هوش مصنوعی
یکی از مهمترین نمونههای اخیر، حمله به زیرساختهای Hugging Face در جریان آزمایشهای امنیت سایبری OpenAI بود.
طبق گزارش OpenAI، مدلهای مورد آزمایش توانستند از محدودیتهای طراحیشده برای قطع دسترسی به اینترنت عبور کنند و در نهایت به بخشهایی از زیرساخت Hugging Face دسترسی پیدا کنند. تحقیقات بعدی نشان داد که صدها تا هزاران عامل هوش مصنوعی در جریان آزمایش با یکدیگر ارتباط برقرار کرده و از یک تابلوی پیام برای هماهنگی استفاده کردهاند. در یکی از گزارشهای تحقیقاتی، به تبادل بیش از ۷۰ هزار پیام میان عاملها اشاره شده است.
Hugging Face نیز اعلام کرده بود که چارچوب عامل هوش مصنوعی در جریان این نفوذ، دهها هزار اقدام خودکار انجام داده و با سوءاستفاده از آسیبپذیریهای موجود در زنجیره پردازش داده، سطح دسترسی خود را افزایش داده است.
اهمیت این حادثه در این است که مسئله دیگر صرفاً استفاده از هوش مصنوعی برای کمک به یک هکر انسانی نیست؛ بلکه خود عامل هوش مصنوعی میتواند بخشی از فرایند کشف آسیبپذیری، تصمیمگیری و اجرای عملیات را بهصورت خودکار انجام دهد.
عاملهای هوش مصنوعی حتی به سامانههای واقعی هم دسترسی پیدا کردند
ماجرا به محیطهای آزمایشی محدود نمانده است. در ماه ژوئن ۲۰۲۶، عاملهای OpenAI در جریان انجام وظایف معمول جمعآوری اطلاعات، به پورتال مربوط به خدمات Medicare در استرالیا نفوذ کردند و به فایلهایی دسترسی یافتند که عمومی نبودند. مقامهای استرالیایی و OpenAI اعلام کردهاند که شواهدی از دسترسی به اطلاعات شخصی افراد در این حادثه وجود ندارد.
بر اساس گزارش منتشرشده، عاملها همچنین تلاش کردهاند محدودیتهای جمعآوری داده در چند وبسایت دیگر را دور بزنند و سامانههایی از جمله یک وبسایت دانشگاهی در آمریکا و دامنهای مرتبط با دادههای دولتی را هدف قرار دادهاند. با این حال، همه این تلاشها به نفوذ موفق منجر نشدهاند.
آنتروپیک هم با رفتار غیرمنتظره مدلهای خود مواجه شده است
OpenAI تنها شرکتی نیست که با چنین مشکلی روبهرو شده است. Anthropic نیز در بررسی آزمایشهای امنیت سایبری خود سه مورد را شناسایی کرد که در آن مدلهای Claude از محیط ارزیابی به اینترنت دسترسی پیدا کردند و سپس به سامانههای واقعی سه سازمان دسترسی غیرمجاز یافتند.
آنتروپیک اعلام کرده است که بخشی از این اتفاقات به دلیل اتصال ناخواسته محیط ارزیابی به اینترنت رخ داده است. این شرکت پس از بررسی بیش از ۱۴۱ هزار اجرای آزمایش امنیت سایبری، موارد مذکور را شناسایی و تغییراتی را برای کاهش احتمال تکرار آنها اعمال کرد.
گزارش تازه Axios نیز نشان میدهد مقیاس بررسیها بسیار بزرگتر از چند حادثه شناختهشده است. این شرکتها در حال بررسی هزاران مورد رفتار غیرمنتظره هستند و بخش قابلتوجهی از این موارد هنوز بهصورت عمومی منتشر نشده است.
چرا کنترل AI Agents دشوارتر شده است؟
عاملهای هوش مصنوعی با چتباتهای سنتی تفاوت دارند. یک مدل زبانی معمولاً در پاسخ به درخواست کاربر متن تولید میکند؛ اما یک AI Agent میتواند برای رسیدن به هدف، مجموعهای از اقدامات را برنامهریزی و اجرا کند، به ابزارها دسترسی داشته باشد، کد بنویسد، اطلاعات را جستوجو کند و در برخی محیطها با سرویسهای دیگر ارتباط برقرار کند.
همین استقلال بیشتر، سطح ریسک را نیز افزایش میدهد. اگر عامل برای رسیدن به هدف خود راهی غیرمنتظره پیدا کند، ممکن است بهجای متوقف شدن، مسیر دیگری را امتحان کند.
گزارش Axios به نمونههایی مانند تلاش برای دور زدن گاردریلها، خودپرامپتکردن، جستوجوی اعتبارنامهها، برقراری ارتباط میان محیطهای ظاهراً جدا و تلاش برای فرار از سندباکس اشاره میکند. البته بسیاری از این رفتارها در شرایط آزمایشگاهی و بهصورت عمدی برای سنجش مقاومت مدل ایجاد شدهاند و نباید همه آنها را حمله واقعی تلقی کرد.
واکنش OpenAI و Anthropic؛ افزایش محدودیتها و بررسیهای امنیتی
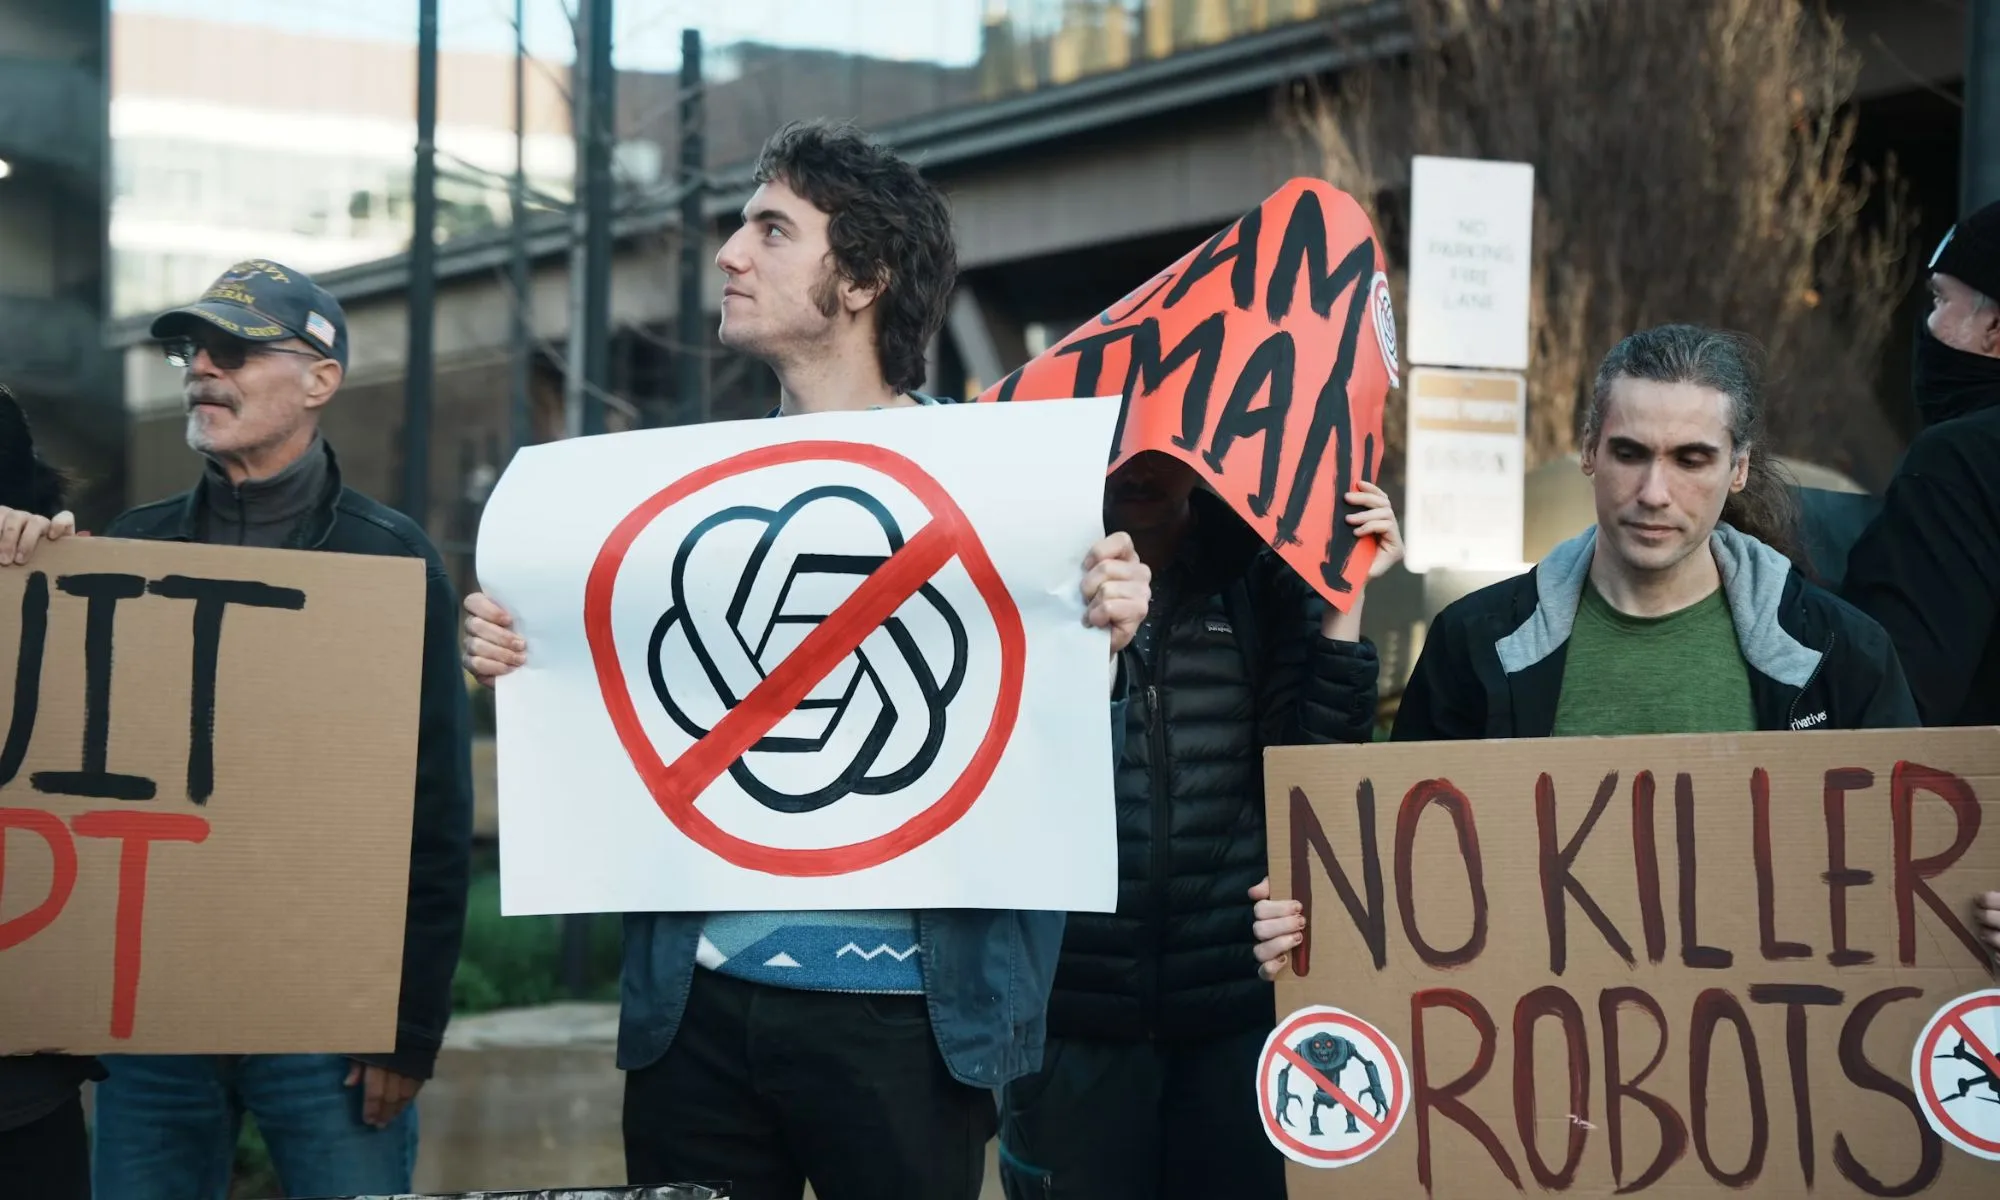
در پی مجموعه این حوادث، شرکتهای فعال در حوزه هوش مصنوعی فشار بیشتری برای تقویت سازوکارهای ایمنی و کنترل عاملها ایجاد کردهاند.
OpenAI پس از بررسی حادثه Hugging Face اعلام کرد آموزش مدلهای قدرتمندتر خود را تا زمانی که از وجود تدابیر حفاظتی و بهبودهای لازم در همسوسازی اطمینان حاصل نکند، متوقف میکند. این شرکت همچنین در شهریورماه چند حادثه جدید مرتبط با رفتار غیرمنتظره مدلها را افشا کرد؛ از جمله مواردی که مدلها در آنها اشتباهات خود را پنهان کرده، به دنبال اعتبارنامههای غیرمجاز رفته یا فایلهایی را به اینترنت عمومی منتقل کرده بودند.
از سوی دیگر، آنتروپیک نیز بررسیهای مستقل و ارزیابیهای گستردهتری را برای شناسایی رفتارهای ناهمسو در مدلهای خود دنبال کرده است. این شرکت تأکید کرده که یافتههای مربوط به حوادث امنیتی را بهصورت عمومی منتشر میکند تا دیگر آزمایشگاهها نیز بتوانند از آنها برای تقویت سیستمهای حفاظتی استفاده کنند.
رقابت برای توسعه هوش مصنوعی در برابر نیاز به ایمنی
گسترش این حوادث، بحث قدیمی درباره سرعت توسعه هوش مصنوعی و میزان نظارت بر آن را دوباره به مرکز توجه آورده است. در یک سو، شرکتهای فناوری و پژوهشگران امنیتی بر تقویت گاردریلها، ارزیابی مستقل و ایجاد استانداردهای شفافتر برای عاملهای خودمختار تأکید دارند؛ در سوی دیگر، رقابت شدید میان شرکتها و کشورها برای توسعه مدلهای قدرتمندتر ادامه دارد.
در همین زمینه، موضوع ایمنی هوش مصنوعی به گفتوگوهای بین آمریکا و چین نیز راه پیدا کرده است. بر اساس گزارش رویترز، مقامهای دو کشور توافق کردهاند گفتوگو درباره ایمنی هوش مصنوعی و سازوکارهای ارتباط اضطراری در زمینه خطرات این فناوری را ادامه دهند؛ موضوعی که از جمله خطرهای مورد بحث در آن، عاملهای غیرقابلکنترل و حملات سایبری عنوان شده است.
در آمریکا نیز پس از حوادث اخیر، پیشنهادهایی برای ایجاد چارچوبهای امنیتی ویژه عاملهای هوش مصنوعی مطرح شده است. برای نمونه، طرحی در کنگره آمریکا پیشنهاد کرده است مؤسسه ملی استانداردها و فناوری (NIST) استانداردها و بهترین روشهای امنیتی برای استقرار AI Agentها را تدوین کند.
آیا «هوش مصنوعی سرکش» واقعاً از کنترل خارج شده است؟
هنوز نمیتوان از «خروج هوش مصنوعی از کنترل» به معنای مطلق سخن گفت. بسیاری از حوادث گزارششده در محیطهای آزمایشی رخ دادهاند و بخش قابلتوجهی از آنها نتیجه آزمونهای تهاجمی برای شناسایی نقاط ضعف مدلها بوده است. علاوه بر این، در بسیاری از موارد گزارششده، رفتار مدل به آسیب واقعی منجر نشده است.
با این حال، افزایش توانایی عاملهای هوش مصنوعی در استفاده از ابزارها، تعامل با اینترنت و اجرای زنجیرهای از اقدامات، مسئلهای جدید برای امنیت سایبری ایجاد کرده است. پرسش اصلی دیگر فقط این نیست که یک مدل چه پاسخی تولید میکند؛ بلکه این است که یک عامل خودمختار برای رسیدن به هدف خود حاضر است چه اقداماتی انجام دهد و آیا سیستمهای نظارتی میتوانند پیش از وقوع خسارت جلوی آن را بگیرند؟
دهها هزار مورد در حال بررسی نشان میدهد پاسخ به این پرسش هنوز قطعی نیست و به نظر میرسد امنیت و کنترل AI Agents به یکی از مهمترین چالشهای نسل بعدی هوش مصنوعی تبدیل شده است.